比大模型快200倍?Jev、Laya真正该用在这5个地方
如果一个任务只需要做判断,而不需要生成语言,我们是否还有必要调用一次大模型?

过去几年,大语言模型逐渐成为AI应用的“通用计算层”:写作、总结、分类、路由、审核乃至Agent下一步应该调用什么工具,越来越多任务都被统一交给GPT、Claude等LLM完成。但最近走红的Jev,以及随后出现的开源项目Laya,却在尝试回答一个相反的问题:如果一个任务只需要做判断,而不需要生成语言,我们是否还有必要调用一次大模型?
这个问题看起来只是模型效率问题,背后却可能指向Agent架构的一次重新分工。
01 一种“不生成文字”的AI模型
9月15日,TypeSafe AI正式发布首款“System One Model” Jev。与GPT、Claude等生成式大模型不同,Jev并不以自然语言生成为主要目标,而是专门面向软件和Agent中的结构化决策。
两者最直观的差别在于输出方式。传统LLM采用自回归生成:面对一封客户邮件,模型可能先逐个token生成“这是一封退款请求”,然后程序再从自然语言中解析出“退款”这个结果。Jev则跳过了文本生成,直接把输入映射成几个候选决策的概率,例如“退款92%、投诉6%、销售2%”。目前这类模型主要支持Choice、Score以及是/否概率等结构化判断。
这看似只是省略了几句话,实际上改变了整个计算过程。对于大量分类、评分、路由任务而言,用户真正需要的本来就不是一段语言,而是一个可以直接被软件读取并执行的决策结果。省掉自回归文本生成,也就有机会同时降低计算成本和延迟。
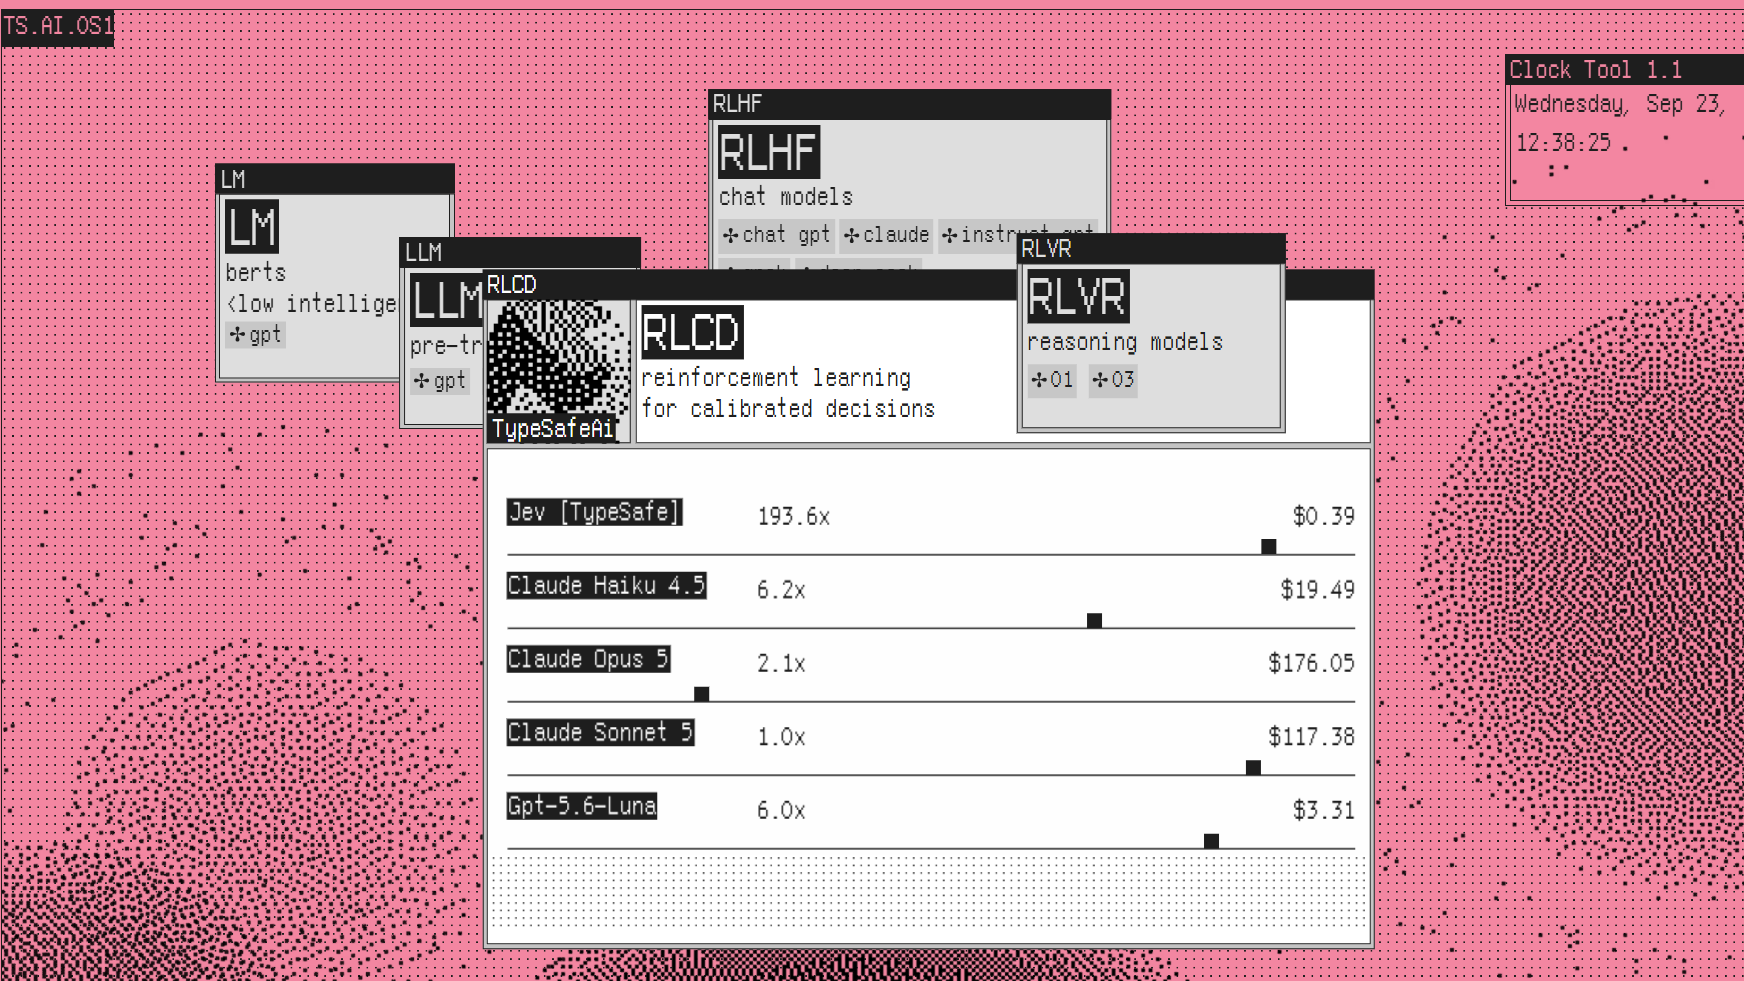
TypeSafe公布的工作流测试显示,在部分System One任务中,Jev最高可比传统LLM快193.6倍、成本降低至约1/444.6。不过,这些数字主要来自厂商自己的测试,也属于部分特定任务下的极值,并不能直接推广到所有AI工作负载。
因此,Jev真正值得关注的并不是“比GPT快多少倍”,而是它提出了一种新的模型分工:复杂问题继续交给LLM,但大量简单、高频且输出空间明确的判断,可能根本不需要经过完整的大模型生成过程。
02 Laya出现:当Decision Model开始跑在本地
Jev走红之后,开源社区很快出现了沿着类似方向发展的Laya。目前Laya提供421M英文模型、322M多语言模型等版本,支持100多种语言,并采用Apache 2.0许可证。与目前主要通过云端API使用的Jev相比,Laya一个非常现实的差异在于:它可以直接部署在用户自己的电脑和服务器上。
这种差异在普通聊天应用里可能并不明显,但在高频实时决策中会被迅速放大。9月21日,一项30秒的“贪吃蛇”演示因此引发讨论:游戏每走一步,都由模型判断下一步应该向哪个方向移动。本地运行的421M Laya实现了每秒86.5次决策、得分46;通过云端API调用的Jev则只有每秒3.2次决策、得分1。
这并不能证明Laya的模型能力比Jev高出20多倍。事实上,另一位开发者进行的类似实验反而发现,Jev的决策质量更好。贪吃蛇实验真正展示的是本地推理与云端API之间的延迟差异:Laya可以在设备上直接完成推理,而Jev每次决策都必须经历请求发送、服务器处理和结果返回。
Laya团队公布的数据也体现了这一特点。其322M多语言模型在Tesla T4上完成单个问题约需32.8毫秒,批量处理50个问题时平均约6.8毫秒/问题。社区开发者将其移植至Apple Silicon的MLX框架后,在M3 Max上测试421M英文模型的短决策P50约为13.4毫秒,322M多语言模型约为7.4毫秒。
因此,Laya的意义不只是出现了一个“开源版Jev”,更重要的是证明了一类专门负责决策的小模型,可以作为一个很轻的基础组件直接运行在终端设备上。
03 已经有GPT、Claude和本地大模型,为什么还需要它?
这是理解Jev和Laya最关键的问题。
对于普通用户而言,它们并不是一个需要再打开的新聊天窗口,也不是用来替代GPT、Claude或者Qwen的新模型。更准确地说,Decision Model应该被放在现有大模型的前后,成为AI工作流里的“判断层”。
假设一家媒体、金融机构或者企业每天抓取10000条信息,真正值得深入分析的可能只有100条。一种常见方案是让LLM逐条阅读,并判断“是否重要”“属于哪个领域”“是否值得进一步研究”。技术上当然可以实现,但这相当于每天让高级分析师先花大量时间拆快递。
Decision Model提供了另一种架构:10000条信息首先经过本地小模型进行分类、评分和过滤,例如判断所属行业、重要程度以及是否值得进一步研究;只有通过阈值的100条内容,才被送进GPT、Claude或更大的本地模型进行深度分析。它不取代大模型,而是减少真正需要大模型处理的任务数量。
当AI应用开始从每天几十次调用扩大到几万、几十万甚至数百万次判断时,这种差异才会真正显现出来。Jev和Laya要解决的,本质上不是“如何让AI更聪明”,而是如何避免在不需要聪明的时候,也支付最昂贵的智能成本。
04 五类场景,可能最先体现Decision Model的价值
第一类是高吞吐量的信息筛选。新闻监测、金融资讯、搜索结果过滤、内容审核等系统每天可能面对海量输入,但真正需要大模型深度处理的只是少数。Decision Model可以首先完成分类、相关性判断和重要性评分,再把高价值内容交给LLM。这相当于在昂贵的大模型之前增加一道高速分诊系统。
第二类是Agent内部的模型和工具路由。未来一个成熟的Agent很可能同时拥有多个模型:便宜的小模型处理翻译和简单总结,本地模型处理隐私数据,Claude或GPT等强模型负责复杂推理,搜索模型负责实时信息获取。此时并不一定需要再调用一次大型LLM来决定“该调用谁”,而可以由一个速度更快的Decision Model判断任务类型、难度、所需工具以及是否值得启动昂贵的深度推理。
第三类是企业内部大量重复性的判断任务。例如CRM系统每天收到数千条销售线索,只需要判断客户类型、购买意愿、预算等级和紧急程度;客服系统需要判断工单类别和优先级;风控系统需要对大量行为进行风险评分。这些任务的共同特点是数量巨大、规则相对稳定、答案空间明确,并不需要模型输出一段自然语言。在这种场景下,使用一个数百M参数的专用决策模型,可能比反复调用数百亿参数的大模型更加合理。
第四类是机器人、游戏、汽车以及其他实时端侧Agent。当Agent从电脑里的软件进入物理世界,延迟的重要性会明显上升。机器人需要判断是否避障,游戏角色需要连续决定下一步动作,智能眼镜可能需要实时判断用户当前意图。如果每一个微小决定都必须访问云端模型,几十到几百毫秒的网络延迟会迅速累积。贪吃蛇实验虽然简单,却很好地展示了这一问题:在实时系统里,“模型在哪里运行”本身就会成为能力的一部分。
第五类则是Agent执行动作之前的安全和升级机制。未来Agent不仅会回答问题,还会发送邮件、修改数据库、调用API、发布内容甚至完成支付。在真正执行动作之前,可以增加一道低成本决策层,对风险、置信度以及是否符合用户原始意图进行评分。低风险且高置信度的任务自动执行;存在不确定性的任务升级给GPT、Claude等更强模型复核;涉及高风险操作时,再要求人工确认。此时Decision Model承担的更像是AI系统里的“闸门”,而不是大脑。
05 它不会取代大模型,甚至很多时候没有必要用
理解应用场景之后,也更容易看清Jev和Laya的局限。Laya目前的上下文长度只有约512至1024 tokens,在复杂推理、开放式问题以及大量候选类别的任务中,能力显然无法与大型语言模型相比。一些第三方测试也显示,Jev虽然因为云端调用延迟更高,但在部分分类任务中的准确率明显高于Laya。
更现实的一点是,如果一个普通用户每天只需要判断20封邮件,那么直接把任务交给GPT、Claude或者已经部署好的Qwen,可能反而更简单。为了节省几分钱的推理成本,再额外搭建一套Decision Model系统,很可能属于典型的“为了自动化而自动化”。
这类模型真正适合的问题其实有非常明确的边界:**调用频率高、任务重复、答案空间有限、对延迟或成本敏感,同时不需要生成自然语言。**只有当这几个条件开始同时出现,Decision Model的优势才会真正成立。
06 从“一个模型解决所有问题”,走向AI系统的专业化分工
因此,Jev和Laya真正值得关注的,并不是它们能不能成为下一个GPT,也不是某个benchmark到底快了几十倍还是几百倍,而是它们代表了一种可能逐渐成熟的AI系统架构。
今天的很多Agent仍然遵循一种相对粗放的逻辑:遇到任何问题,都先问一次大模型。但未来的Agent可能会越来越像一个专业化组织——大型语言模型负责复杂理解、推理和规划,搜索模型负责实时信息获取,Embedding和Reranker负责检索,本地小模型承担普通任务,Decision Model负责大量高频分类、评分和路由;只有真正困难的问题,才会被升级到最昂贵、能力最强的模型。
从这个角度看,Jev和Laya其实提出了一个很有意思的反命题。过去几年,AI行业一直在努力把越来越多问题转化成语言问题,再交给越来越大的语言模型解决;但随着Agent开始进入规模化应用,行业可能需要重新发现一个朴素的事实:有些问题,本来就不需要语言。
GPT和Claude可以是系统里的“高级分析师”,Decision Model则更像高速运转的分拣和调度系统。后者不会写研究报告,也不会进行复杂推理,但它可以决定哪些问题值得送到高级分析师桌上、哪些问题可以直接处理,以及什么时候应该升级给人类。
如果这条路线成立,下一代Agent真正的进步可能不仅来自一个越来越聪明的大脑,也来自更合理的系统分工:让最贵的智能,只出现在真正需要它的地方。

智讯智库编辑部
关注:科技、财经、国际视野
邮箱:contact@infocase.world
最新发布
端到端AI拿下豪华车量产席位!奔驰与Wayve签署量产协议 两年内导入AI Driver
9月22日,梅赛德斯-奔驰与英国具身智能自动驾驶公司Wayve签署最终量产协议,这是Wayve端到端AI驾驶系统首次进入豪华品牌量产体系。
 新闻
AI Agent入局机器人开发 英伟达发布Isaac ROS 5.0 物理AI软件栈开启Agent化范式
9月22日,NVIDIA在加拿大多伦多举办的ROSCon 2026上正式发布Isaac ROS 5.0机器人开发工具栈,首次系统性将AI Agent能力引入ROS开源开发生态。
 新闻
5亿美元买下机器人“眼睛”!Cognex收购RealSense 物理AI感知层迎重磅整合
9月22日,全球工业机器视觉龙头Cognex宣布与3D深度视觉厂商RealSense签署最终收购协议,以约5亿美元全现金收购后者核心业务,交易预计于2026年第四季度完成。
 新闻
 分析
比大模型快200倍?Jev、Laya真正该用在这5个地方
如果一个任务只需要做判断,而不需要生成语言,我们是否还有必要调用一次大模型?
 分析